Lo más peligroso del OCR es que nunca parece inseguro. Dele un informe del personal nítido de 2019 y devuelve texto limpio; dele una ordenanza enviada por fax en 1987 y devuelve texto con el mismo formato seguro, parte de él incorrecto. Para las entidades públicas que miran décadas de actas y registros escaneados, saber cuándo el OCR ayuda y cuándo miente es la diferencia entre un archivo accesible y uno que solo lo parece.
¿Por qué un PDF escaneado falla todas las comprobaciones de accesibilidad?
Porque un escaneo es una fotografía de papel. No hay texto que un lector de pantalla pueda leer, nada que la búsqueda pueda encontrar, ninguna estructura que recorrer, y ninguna cantidad de etiquetado arregla una página sin capa de texto. Todo documento escaneado falla los requisitos de alternativas textuales de WCAG 2.1 hasta que el OCR o la recreación le dan texto real y correcto.
Esto incluye el caso intermedio engañoso: los escaneos "con búsqueda" que tienen una capa de texto oculta generada por el OCR integrado de una copiadora. La página se ve igual, la búsqueda más o menos funciona, y la capa de texto de abajo puede estar llena de errores que nadie ha leído nunca.
¿Cuándo ayuda el OCR?
En páginas limpias, modernas e impresas a máquina, el OCR es el primer paso honesto, y uno muy bueno. El reconocimiento en un documento bien escaneado e impreso en láser es lo bastante preciso como para que el texto reconocido sostenga todo lo que se construye encima: etiquetado, orden de lectura, metadatos, búsqueda. En un proceso de remediación, el OCR corre primero y el resto del trabajo se apoya en el texto que produce, y por eso mismo su calidad limita la calidad de todo lo que viene después.
Si su material escaneado es en su mayoría reciente —carpetas de sesión escaneadas por comodidad, cartas firmadas, informes del personal impresos y escaneados—, el OCR más una remediación normal recuperará bien la mayor parte.
¿Cuándo miente el OCR?
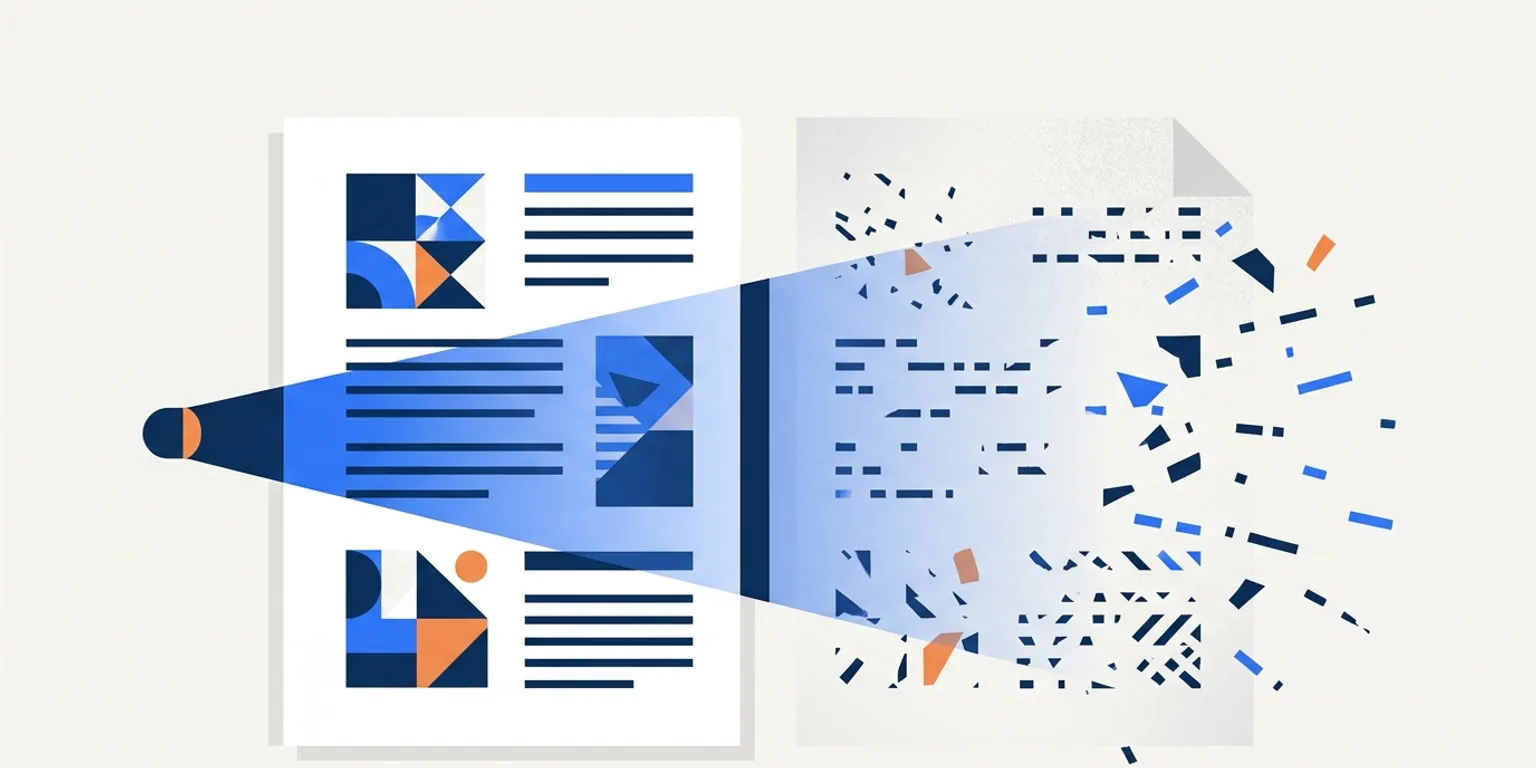
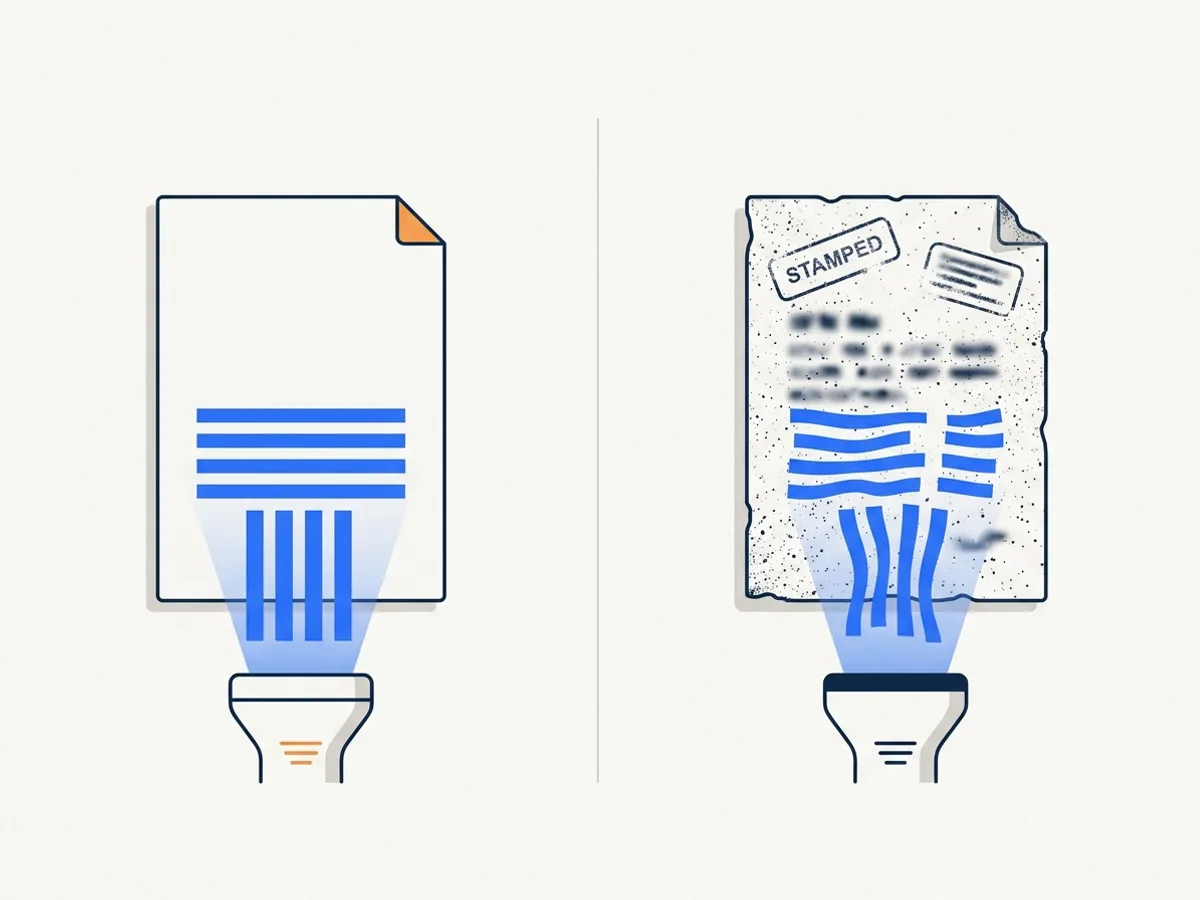
Cuando la fuente se degrada, el OCR se degrada, pero en silencio. La investigación sobre digitalización a gran escala encontró que la precisión del OCR en material histórico y de archivo varía enormemente según la fuente, y cae muy por debajo de lo utilizable en originales de mala calidad (Holley, D-Lib Magazine, 2009). Los culpables clásicos de los archivos públicos: copias de fax, sellos y anotaciones a mano sobre el texto, impresiones de microfilm de baja resolución, diseños apretados de varias columnas y tablas cuyas filas se disuelven en una sopa de palabras.
El modo de falla no es un galimatías; un galimatías sería fácil de detectar. Es una fecha leída como 1998 en lugar de 1993, un monto al que le falta un dígito, un nombre mal escrito con toda seguridad. Para registros legales como actas y ordenanzas, un texto plausible pero incorrecto servido a un usuario de lector de pantalla es probablemente peor que ningún texto, porque nada señala que no se debe confiar en él.
¿Cómo comprobar si el OCR dijo la verdad?
Tome muestras contra la imagen. Elija páginas a lo largo del documento —no solo la primera página, la limpia— y lea el texto reconocido junto al escaneo, prestando especial atención al contenido que importa si está mal: fechas, montos, nombres, números de sección, celdas de tablas. Un documento puede tener un 98 % de precisión por carácter y aun así tergiversar la única moción que alguien vino a buscar.
Las puntuaciones de confianza ayudan a dirigir el muestreo, pero no pueden reemplazarlo: los motores de OCR informan qué tan seguros estaban, y las regiones de baja confianza merecen primero una mirada humana. La regla práctica es la proporcionalidad: un boletín rutinario merece una revisión puntual; una ordenanza o un conjunto de actas aprobadas merece una revisión real antes de que su capa de texto se publique como el registro.
¿Qué parte de un rezago público está escaneada?
En el sitio en vivo, menos de lo que la mayoría supone, y la cifra se mide en lugar de suponerse. Para las 22 entidades públicas cuyas estadísticas de rastreo publicamos en nuestro directorio de fechas límite (rastreos del 17 y 18 de septiembre de 2026), el rastreador muestreó hasta 50 PDF enlazados públicamente por sitio —944 en total— y comprobó, en cada uno que pudo abrir, si había capa de texto. La proporción de archivos de solo imagen fue del 0 % al 19 % según la entidad, con una mediana de alrededor del 4 %; los tres condados del conjunto fueron los más altos, entre 10 % y 13 %, y diez de los 22 sitios no tenían ningún escaneo en su muestra. Esa cifra describe lo que un sitio enlaza hoy, no lo que guarda un archivo de registros: todo lo publicado antes de que una oficina pasara a lo digital primero existe solo como imagen de papel, y un archivo profundo de actas, ordenanzas y correspondencia puede no parecerse en nada al 4 % del sitio en vivo. Su propia cifra se puede conocer en lugar de adivinar: un escaneo de documentos de su sitio separa los archivos de solo imagen de los nacidos digitales.
¿Qué hacer con un rezago escaneado?
Priorice antes de pasar nada por OCR. Una gran parte de un archivo escaneado puede estar legítimamente cubierta por la excepción de contenido archivado de Title II —conservada solo para referencia o archivo, en un área de archivo dedicada— o simplemente lista para retirarse (hoja informativa de ADA.gov). Lo que queda es el material que la gente usa actualmente, y ahí es donde corresponde el presupuesto de OCR más revisión.
El proceso de DocoMatic trata el OCR como un paso que debe ganarse la confianza: las páginas de solo imagen se detectan durante el descubrimiento, el OCR corre como complemento con precio (dos créditos por página) y el reconocimiento de baja confianza se marca para revisión humana en lugar de publicarse como si fuera verdad. Donde la precisión no se puede rescatar, las opciones honestas son volver a teclear, recrear desde el archivo original o decidir que el futuro del documento es el archivo, con remediación a solicitud.
El OCR es una buena herramienta y un pésimo testigo. Úselo donde es fuerte, compruébelo donde es débil y nunca lo deje testificar sin supervisión.
Este artículo no constituye asesoría legal. Para las obligaciones de cumplimiento de su organización, consulte a su asesor jurídico.
Temasocrscannedpdfarchives
Sobre el autor
Rakesh Patel — Director ejecutivo y fundador
Rakesh Patel es el fundador y director ejecutivo de DocoMatic y el fundador de Space-O Technologies (2010), la empresa de ingeniería que la respalda. Aporta 32 años de experiencia de liderazgo en estrategia de negocios, operaciones y TI, y ha supervisado la entrega de más de 3,000 proyectos de software. DocoMatic aplica esa experiencia de entrega a un problema concreto: hacer accesibles los documentos públicos, de forma verificable.